O que é um LLM?

Um LLM (do inglês Large Language Model, ou Modelo de Linguagem de Grande Escala) é um tipo de inteligência artificial treinado para compreender, processar e gerar linguagem humana de forma natural.

Popularizados nos últimos anos com o lançamento de diversos chatbots inteligentes, os LLMs vêm sendo amplamente adotados em todas as áreas do mercado, não ficando restritos apenas à produção de códigos e conteúdos digitais.

Neste artigo, vamos conhecer um pouco mais sobre o que são os LLMs e como usá-los em nosso dia a dia.

1 – Entendendo o que é um LLM

De forma simplificada, podemos entender que um LLM é um modelo de inteligência artificial treinado com grandes quantidades de dados para aprender padrões da linguagem e, a partir desses padrões, gerar ou transformar texto em linguagem humana.

Um LLM não é simplesmente um banco de dados contendo textos. Ele não funciona como:

Receber pergunta → procurar resposta em um banco → retornar resposta

O funcionamento é muito mais próximo de:

Entrada
 ↓
Transformação em tokens
 ↓
Processamento pelo modelo
 ↓
Cálculo de probabilidades
 ↓
Escolha do próximo token
 ↓
Repetição
 ↓
Resposta

Considere, por exemplo, a frase: “O Brasil fica na América”. O modelo pode representar a continuação da frase com base em probabilidades:

do Sul -> 81%
Latina  -> 15%
Central -> 2%
...

Então ele escolhe um próximo token e continua calculando o próximo, repetidamente, até produzir a resposta completa. Chamamos isso de modelo preditivo, uma técnica baseada na previsão (cálculo de probabilidades) de quais palavras, trechos ou unidades de texto fazem mais sentido para a sequência da resposta.

2 – Como um LLM funciona?

Podemos dividir o funcionamento de um LLM em duas etapas principais: Treinamento e Utilização.

TREINAMENTO

Dados
  ↓
Tokenização
  ↓
Transformer
  ↓
Predição
  ↓
Cálculo do erro
  ↓
Atualização dos parâmetros
  ↓
Repetição milhões/bilhões de vezes
UTILIZAÇÃO

Prompt
  ↓
Tokenização
  ↓
Transformer
  ↓
Probabilidades
  ↓
Próximo token
  ↓
Próximo token
  ↓
...
  ↓
Resposta

Essas são as duas etapas macro do funcionamento de um LLM. A seguir, vamos detalhar alguns aspectos fundamentais dos LLMs:

2.1 – Tokens

Os LLMs não trabalham diretamente com palavras, na realidade, eles trabalham com tokens.

Um token pode representar: uma palavra; parte de uma palavra; uma pontuação; um espaço; algum símbolo (caractere especial), algum número, etc.

Por exemplo, considere a frase: “Eu trabalho com desenvolvimento de software.” Essa frase pode ser convertida para algo conceitualmente parecido com:

[Eu] [ trabalho] [ com] [ desenvolvimento] [ de] [ software] [.]

Os tokens recebem identificadores numéricos:

[1532, 8921, 47, 19382, 521, 8321, 13]

Esses números são então utilizados pelo modelo de linguagem para processar a pergunta recebida e fornecer uma resposta para ela.

Então, se você ouvir uma frase como: “Este modelo possui contexto de 1 milhão de tokens”. Entenda que isso não significa 1 milhão de palavras. Tokens e palavras não são equivalentes. Modelos com mais tokens tendem a ser mais precisos e eficazes em suas respostas.

2.2 – Embeddings

Depois que o texto é dividido em tokens, o modelo transforma esses tokens em uma representação que possa ser processada matematicamente. Para isso, cada token é associado a um vetor numérico, chamado embedding.

De forma simplificada, embeddings são mais ou menos assim:

"rei"      → [0.21, -0.73, 0.14, 0.91, ...]
"rainha"   → [0.19, -0.68, 0.17, 0.88, ...]
"homem"    → [0.32, -0.51, 0.09, 0.72, ...]
"mulher"   → [0.29, -0.47, 0.12, 0.70, ...]

Esses números não representam diretamente características como “masculino”, “feminino”, “nobreza” ou “pessoa”. O modelo aprende, durante o treinamento, uma representação matemática na qual relações entre conceitos podem ser capturadas pelos vetores.

Pense, por exemplo, que o modelo aprenda uma relação aproximada entre essas palavras:

homem ─────────► mulher
rei   ─────────► rainha

Na prática, o modelo não aprende apenas que “homem” e “mulher, “rei” e “rainha” são palavras relacionadas. Ele aprende padrões mais abstratos sobre como esses conceitos se relacionam entre si.

É justamente essa capacidade de representar relações semânticas e contextuais por meio de estruturas matemáticas que permite ao modelo trabalhar com conceitos, em vez de tratar cada palavra como um elemento completamente isolado.

2.3 – Transformer

Aqui chegamos ao componente fundamental da maioria dos LLMs modernos: o transformer.

A arquitetura Transformer foi apresentada em 2017 no trabalho acadêmico: Attention Is All You Need. Essa arquitetura revolucionou o processamento de linguagem natural.

Um Transformer possui diversos componentes, mas um dos mais importantes é o mecanismo de Attention — atenção.

2.3.1 – Attention

Imagine a frase: “O desenvolvedor colocou o código no repositório porque ele precisava ser revisado.” Quando o modelo processar a palavra “ele“, precisa entender a que “ele” está se referindo.

A atenção permite que diferentes partes da sequência influenciem umas às outras. De maneira extremamente simplificada:

O desenvolvedor colocou o código no repositório
       ↓                    ↓
       └────── atenção ────┘

O modelo aprende quais partes da entrada são relevantes para interpretar cada token. E isso é extremamente importante porque permite trabalhar com contexto.

2.4 – Parâmetros

Durante o treinamento, o modelo possui enormes quantidades de parâmetros.

Você pode pensar nos parâmetros como os valores internos que o modelo ajusta para aprender os padrões existentes nos dados.

Inicialmente:

Parâmetros
 ↓
Valores essencialmente aleatórios

Durante o treinamento:

dados
 ↓
previsão
 ↓
erro
 ↓
ajuste dos parâmetros
 ↓
nova previsão
 ↓
...

Depois de bilhões de exemplos:

Parâmetros ajustados
      ↓
Modelo treinado

É importante entender que o conhecimento do modelo não fica armazenado como uma coleção de frases individuais. Ele é distribuído pelos parâmetros e pela estrutura aprendida pelo modelo.

2.5 – Treinamento

O treinamento serve para ‘ensinar’ a previsão do próximo token para o modelo, evitando erros na geração das respostas.

Imagine que o modelo recebe essa pergunta: “O céu é de qual cor?”

Talvez inicialmente ele produza uma resposta como: “verde“. Mas o dado de treinamento indica: “azul“.

Aqui existe um erro. O treinamento irá utilizar esse erro para ajustar os parâmetros e esse processo acontecerá repetidamente em uma escala gigantesca. Uma forma simplificada de visualizar isso é:

Entrada: "O céu é"
 ↓
Modelo
 ↓
Predição: "verde"
 ↓
Comparação
 ↓
Resposta esperada: "azul"
 ↓
Erro
 ↓
Atualização dos parâmetros

3 – O modelo “entende”?

Essa é uma das questões filosóficas e técnicas mais interessantes da atualidade.

E aqui existe uma diferença importante: processar e representar padrões não é igual a possuir compreensão humana consciente.

Um LLM pode produzir conteúdos altamente sofisticados e bem elaborados. Ele pode, por exemplo, explicar conceitos de banco de dados de maneira bastante detalhada e aprofundada. Mas isso não significa que o LLM tenha consciência, experiência ou compreensão humana no sentido convencional.

Por isso é mais preciso dizer que: LLMs aprendem representações e padrões extremamente complexos da linguagem e de outros dados, permitindo produzir comportamentos que podem parecer compreensão.

4 – Quais LLMs existem atualmente?

Atualmente, existem diversas famílias de LLMs desenvolvidas por diferentes empresas e comunidades. E cada uma delas tem evoluído rapidamente, entregando resultados cada vez mais surpreendentes e inteligentes aos seus usuários. Em setembro de 2026, alguns dos principais ecossistemas incluem:

Empresa/organizaçãoFamíliaCaracterística
OpenAIGPTRaciocínio, programação e uso geral
GoogleGeminiMultimodalidade e integração completa com ecossistema Google
AnthropicClaudeRaciocínio profundo, escrita e programação
MetaLlamaModelos com pesos disponíveis para desenvolvimento
Mistral AIMistralModelos eficientes e opções open-weight
DeepSeekDeepSeekRaciocínio, programação e modelos de pesos disponíveis
Perplexity AIPerplexityBusca conectada a web, citação direta de fontes e pesquisa aprofundada
xAI
(antigo Twitter)
GrokModelo geral e integração com produtos da xAI

Cada uma dessas famílias de LLMs possui seus pontos fortes e são mais adequadas para determinados contextos e situações. Vale a pena estudar cada uma delas, entender suas aplicações e testá-las no dia a dia.

Todas elas possuem planos gratuitos que atendem a maioria de nossas demandas. Mas também existe a opção de contratação de planos pagos, tanto individuais quanto para equipes. Esses planos fornecem recursos avançados de IA com foco no aumento de produtividade.

———-

Os Modelos de Linguagem de Grande Escala deixaram de ser uma promessa futurista para se tornarem a infraestrutura básica de grande parte dos softwares modernos.

Compreender que eles não “pensam” como nós, mas operam com base em matemática, probabilidades e representações vetoriais, nos ajuda a utilizá-los de forma muito mais eficiente e estratégica.

Mais do que substituir o trabalho humano, os LLMs funcionam como amplificadores de capacidade. O segredo para o sucesso no dia a dia não está em buscar respostas mágicas, mas em dominar a arte de interagir com essas ferramentas — entendendo suas limitações, aproveitando seus pontos fortes e integrando-as de forma inteligente ao seu fluxo de trabalho.

Gostou do conteúdo? Compartilhe com seus amigos e aproveite para conhecer mais sobre inteligência artificial aqui!
O que é Zero Trust?

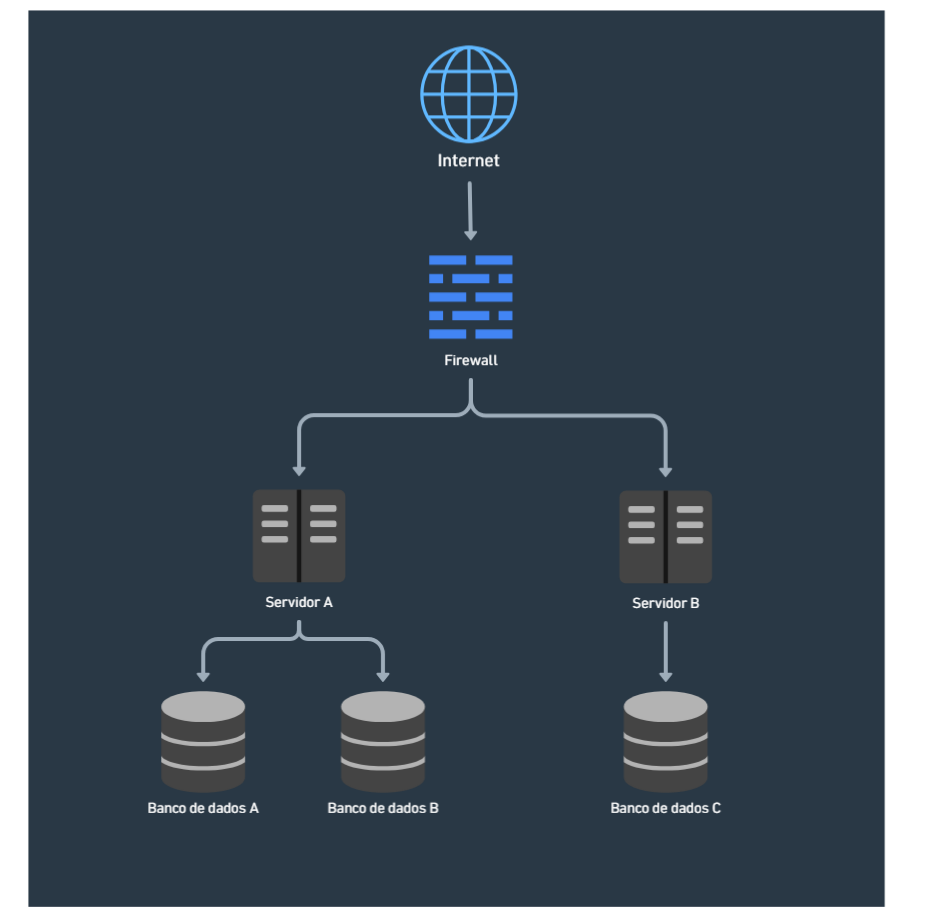
A segurança digital é uma área em permanente evolução. Por muito tempo, a estratégia dominante se baseava no conceito de perímetro: proteger a rede da empresa como um castelo, com muros altos (firewalls) e uma única entrada controlada. O problema é que, uma vez lá dentro, a confiança era automática. Essa abordagem, no entanto, tornou-se obsoleta na era da computação em nuvem, trabalho híbrido e dispositivos móveis. E é aí que entra o Zero Trust.

Zero Trust não é uma tecnologia, produto ou ferramenta específica. Ele é um modelo de segurança que orienta como uma organização deve controlar o acesso aos seus recursos.

Neste artigo, vamos conhecer um pouco mais sobre esse modelo de segurança e entender como ele se aplica ao nosso dia a dia. Vamos lá?

1 – O que é Zero Trust?

Em sua essência, o Zero Trust é um modelo de segurança que se baseia em uma premissa simples, mas radical: nunca confie, sempre verifique. Ele elimina o conceito de confiança implícita dentro da rede.

Isso significa que, independentemente de o usuário ou dispositivo estar dentro ou fora do perímetro tradicional da rede, a confiança nunca é presumida. Cada tentativa de acesso, seja de um usuário, dispositivo ou aplicação, deve ser autenticada, autorizada e continuamente validada.

1.1 – Qual a importância do Zero Trust para os dias de hoje?

A importância do Zero Trust tem aumentado exponencialmente, diante de ataques cibernéticos cada vez mais sofisticados e frequentes, como ransomwares e violações de dados. O modelo tradicional de segurança é vulnerável a ameaças internas e a movimentação lateral de invasores.

Imagine uma empresa com uma rede interna:

No modelo tradicional, a lógica da segurança poderia ser mais ou menos assim: “Se você conseguiu entrar na rede interna, provavelmente é confiável.”

Isso cria uma espécie de zona de confiança. Um funcionário conecta o notebook à VPN, entra na rede corporativa e, depois disso, consegue acessar vários recursos internos.

O problema aparece quando um atacante consegue roubar as credenciais desse funcionário. Ele pode conseguir:

Credencial roubada
       ↓
Acesso à VPN
       ↓
Entrada na rede interna
       ↓
Descoberta de outros servidores
       ↓
Movimentação lateral
       ↓
Acesso a dados sensíveis

Veja que, o firewall protegeu a fronteira externa, mas não impediu necessariamente o atacante de se movimentar dentro da rede. E é justamente aqui que o Zero Trust muda a lógica.

No modelo tradicional: “Confie primeiro e controle depois.”

No Zero Trust:“Não presuma confiança. Sempre verifique antes de conceder acesso.”

Isso não significa que o sistema precisa perguntar a senha a cada requisição. Significa que estar em determinado lugar, possuir determinado IP ou estar conectado à rede corporativa não é suficiente para conceder acesso.

Por exemplo:

Usuário
   │
   ├── identidade
   ├── dispositivo
   ├── localização
   ├── horário
   ├── contexto
   └── recurso solicitado
          │
          ↓
   [Política de acesso]
          │
       ┌──┴──┐
       ↓     ↓
    Permite  Nega

A decisão passa a ser baseada em identidade + contexto + política, e não simplesmente em “está dentro da rede”.

Imagine um funcionário chamado João. Ele possui uma conta legítima: joao@empresa.com

O fato de João ser um funcionário legítimo não significa que ele possa acessar qualquer recurso da empresa. Ele pode ter:

CRM                 ✓
Sistema de vendas   ✓
Sistema financeiro  ✗
Dados de RH         ✗
Controle de estoque ✗

Esse é um dos conceitos mais importantes do Zero Trust: autenticação não é autorização.

Autenticar significa: “Quem é você?”

Autorizar significa: “Você pode fazer isso?”

2 – Os princípios do Zero Trust

O Zero Trust está fundamentado em alguns princípios conceituais básicos:

PrincípioIdeia
Verificar explicitamenteNão conceder acesso baseado em confiança implícita
Privilégio mínimoConceder somente as permissões necessárias
Assumir comprometimentoProjetar o ambiente considerando que um componente pode ser comprometido
Verificação contínuaReavaliar acesso e risco continuamente
SegmentaçãoLimitar a comunicação entre recursos
MonitoramentoRegistrar e analisar atividades para detectar comportamentos suspeitos
Proteção de dadosControlar o acesso aos dados independentemente de onde estejam

A seguir, vamos detalhar um pouco mais cada um desses princípios básicos.

2.1 – Verificar explicitamente

Toda decisão de acesso deve considerar informações relevantes sobre a solicitação. Por exemplo:

Usuário: thiago
Dispositivo: notebook corporativo
Localização: Brasil
Horário: 14:30
MFA: aprovado
Recurso: API de produção

O sistema pode avaliar esses fatores antes de permitir o acesso. Isso é muito mais sofisticado do que:

IP = rede interna -> PERMITIR

2.2 – Privilégio mínimo

O Least Privilege — privilégio mínimo, parte do pressuposto que um usuário, serviço ou aplicação deve possuir somente as permissões necessárias para executar sua função.

Imagine uma aplicação de backend que se comunica com uma base de dados PostgreSQL, por exemplo. Uma implementação ruim poderia utilizar um usuário de banco com:

SELECT
INSERT
UPDATE
DELETE
CREATE
DROP
ALTER

Mas talvez a aplicação precisasse somente de:

SELECT
INSERT
UPDATE

Nesse caso, conceder DROP, ALTER etc. aumenta desnecessariamente o impacto de uma eventual comprometimento da aplicação.

Zero Trust incentiva exatamente essa redução de privilégios.

E isso vale para:

  • usuários;
  • APIs;
  • microsserviços;
  • máquinas;
  • containers;
  • workloads;
  • aplicações;
  • contas administrativas.

2.3 – Assumir que o ambiente já pode estar comprometido

Ao invés de pensar: “Nossa rede é segura.”

O modelo assume algo mais próximo de: “Precisamos operar considerando que um usuário, dispositivo ou componente pode ser ou estar comprometido.”

Isso muda completamente a arquitetura. Imagine:

API Gateway -> Service A -> Service B -> Database

Em uma arquitetura Zero Trust, o fato de Service A estar “dentro da rede” não significa automaticamente que ele pode conversar livremente com Service B.

A comunicação também pode exigir:

Service A -> Autenticação -> Autorização -> Policy -> Service B

Isso é especialmente relevante em arquiteturas de microsserviços, Kubernetes e cloud.

2.4 – Verificação contínua

Outro ponto importante é que a decisão de acesso não precisa ser considerada permanente. Imagine:

09:00: Usuário autenticado -> Acesso permitido

Às 09:10:

Comportamento suspeito -> Dispositivo comprometido -> Sessão/token revogado 
-> Acesso bloqueado

Portanto, Zero Trust trabalha com a ideia de avaliação contínua do risco. Isso pode envolver:

  • identidade;
  • MFA;
  • postura do dispositivo;
  • localização;
  • comportamento;
  • nível de risco;
  • sensibilidade do recurso;
  • horário;
  • contexto da requisição.

2.5 – Segmentação

A segmentação consiste em dividir o ambiente tecnológico em diferentes zonas ou domínios de acesso e controlar explicitamente a comunicação entre eles.

O objetivo é reduzir a capacidade de um invasor se movimentar livremente pelo ambiente caso consiga comprometer algum componente.

Em vez de pensar: “Tudo que está dentro da rede é confiável.”

Pensamos: “Cada recurso deve possuir somente os canais de comunicação necessários.”

Por exemplo:

Aplicação Front-End
  ↓
API de Pedidos
  ↓
Banco de Dados de Pedidos

A API pode acessar o banco de dados porque precisa disso. Mas o frontend não precisa e não deve acessar diretamente o banco. E a API de pedidos provavelmente não precisa acessar o banco de folha de pagamento, por exemplo.

Isso cria fronteiras de segurança menores e mais específicas.

2.6 – Monitoramento

Aqui o princípio é monitorar continuamente o ambiente e registrar as atividades relevantes.

Aqui aparece uma ideia importante: Você não consegue aplicar Zero Trust adequadamente se não consegue observar o que está acontecendo.

Praticamente qualquer evento relevante de segurança deve ser monitorado. Por exemplo:

Login
Logout
Falha de autenticação
Alteração de senha
Uso de MFA
Acesso a API
Acesso a banco
Alteração de permissões
Criação de usuário
Exclusão de usuário
Acesso administrativo
Alteração de configuração

Todos esses eventos podem ser registrados. Porém, aqui temos um ponto importante. Monitoramento no contexto de Zero Trust não significa apenas: “Vamos gerar arquivos de log de tudo que acontece no sistema.”

O objetivo é usar os eventos para tomar decisões de segurança. Por exemplo:

Usuário:
thiago

Comportamento normal:
08:00 → Brasil
09:00 → Brasil
10:00 → Brasil

De repente:

10:15 → acesso da Europa
10:16 → centenas de requisições
10:17 → tentativa de acessar recurso administrativo

O sistema pode identificar um comportamento anômalo. E isso pode resultar em:

Risco aumentado
 ↓
Reautenticação
 ↓
MFA
 ↓
Restrição de acesso
 ↓
Bloqueio

2.7 – Proteção de dados

O último princípio é a proteção dos dados independentemente de onde eles estejam armazenados ou trafeguem.

Esse ponto é particularmente importante porque o Zero Trust muda o foco de: “Como protegemos nossa rede?”

Para: “Como protegemos nossos recursos e, principalmente, os dados que eles contêm?”

Dados não devem ser considerados seguros apenas porque estão “dentro”. Imagine:

Internet
 ↓
Firewall
 ↓
Rede privada
 ↓
Database

O fato do banco de dados estar em uma rede privada não significa que os dados estejam adequadamente protegidos. É necessário controlar:

Quem pode acessar?
O que pode acessar?
Como pode acessar?
Por quanto tempo?
De qual aplicação?
Com qual privilégio?

Imagine um sistema médico. Um usuário da área de atendimento ao cliente pode possuir acesso a:

Paciente
 ├── nome                   ✓
 ├── telefone               ✓
 ├── histórico              ✓
 ├── dados financeiros      ✕
 └── dados administrativos  ✕

Zero Trust incentiva esse tipo de controle granular de acesso aos dados. Isso conversa diretamente com conceitos como:

  • RBAC;
  • ABAC;
  • Classificação de dados;
  • Criptografia;
  • Tokenização;
  • DLP;
  • Mascaramento;
  • Auditoria.

3. Um exemplo muito próximo da realidade

Imagine uma empresa que possui:

  • funcionários;
  • sistema financeiro;
  • CRM;
  • ERP;
  • APIs;
  • banco de dados;
  • Git;
  • Kubernetes;
  • serviços em cloud.

Um funcionário faz login. No modelo tradicional seria algo semelhante a isso:

Login
 ↓
VPN
 ↓
Rede corporativa
 ↓
Acesso a vários recursos internos

No Zero Trust teríamos algo como:

Login
 ↓
MFA
 ↓
Verificação da identidade
 ↓
Verificação do dispositivo
 ↓
Avaliação do contexto
 ↓
Aplicação das políticas
 ↓
Acesso somente aos recursos autorizados

E mesmo depois disso:

Acesso concedido
 ↓
Monitoramento
 ↓
Mudança de risco
 ↓
Reavaliação
 ↓
Revogação, se necessário

3.1 – Então Zero Trust substitui firewall?

Não. E esse é um equívoco comum. Zero Trust não significa: “Jogue fora o firewall.”

O firewall continua sendo uma camada importante de proteção. A diferença é que ele deixa de ser a única ou principal fronteira de confiança.

O Zero Trust é uma estratégia arquitetural de segurança e, portanto, ele deve ser utilizado em conjunto com um firewall robusto e confiável.

———-

Abrangendo desde a aplicação de políticas rigorosas de identidade e acesso — como autenticação multifator e privilégio mínimo — ou reestruturando a arquitetura de redes corporativas em microssistemas segmentados, o modelo Zero Trust entrega a base lógica ideal para blindar ambientes contra ameaças modernas, garantindo estabilidade e resiliência em cenários altamente dinâmicos.

A abordagem Zero Trust transcende a adoção de uma ferramenta ou produto isolado, pois trata-se de uma profunda mudança de mentalidade na forma como concebemos a segurança digital. Ao abandonar a confiança implícita, isolar perímetros internos e validar cada requisição de ponta a ponta, construímos infraestruturas capazes de evoluir com segurança mesmo diante de um mercado impulsionado por sistemas distribuídos e vetores de ataques cibernéticos cada vez mais sofisticados.

Os princípios do Zero Trust deixaram de ser opcionais para se tornarem o padrão ouro na entrega de arquiteturas corporativas robustas, auditáveis e prontas para o presente.

Espero que este texto seja útil de alguma forma para você e contribua com sua jornada acadêmica e profissional!

Gostou do conteúdo? Compartilhe com seus amigos e aproveite para conhecer mais sobre segurança da informação aqui!

O que é programação funcional?

Ao trabalhar com desenvolvimento de software, cada paradigma de programação oferece uma abordagem própria para a solução de problemas reais através de sistemas computacionais. A programação funcional é uma metodologia que tem se destacado nos últimos anos e ganhado cada vez mais relevância devido à sua capacidade de produzir códigos mais previsíveis, testáveis e manuteníveis.  

Neste artigo, iremos explorar os fundamentos da programação funcional e suas principais características. Veremos também alguns exemplos simples e práticos de códigos que nos ajudarão a entender melhor como esse paradigma pode ser aplicado no dia a dia dos programadores. 

1 – Entendendo o conceito de programação funcional 

A programação funcional (do inglês, Functional Programming) é um paradigma de desenvolvimento de software baseado no conceito de expressões e funções matemáticas.

A inspiração do paradigma funcional veio do trabalho dos matemáticos teóricos que lidam com grandes sistemas matemáticos, que possuem muitas abstrações. Ao trabalhar com esses sistemas complexos, a maneira que eles encontraram para chegar no resultado final com sucesso, foram as funções.

Ao contrário do paradigma imperativo, focado em como executar passos sequenciais modificando estados (como nos loops for e while), a programação funcional foca em o que deve ser computado através de expressões determinísticas.

A premissa central é decompor problemas complexos em funções pequenas, puras e isoladas. Cada função atua como uma caixa preta: recebe dados de entrada, realiza seu processamento e retorna um novo valor. Tudo isso, sem alterar variáveis globais ou interagir com o ambiente externo de forma descontrolada (ausência de efeitos colaterais).

Esse isolamento garante alta previsibilidade, facilita testes unitários e entrega excelente suporte a processamento paralelo e concorrente, já que a ausência de estado compartilhado elimina conflitos de memória (race conditions).

Linguagens Mais Adequadas para o Paradigma

  • Linguagens Puramente Funcionais (Functional-First): Projetadas desde a base com foco absoluto no paradigma. Oferecem verificação estática rigorosa, imutabilidade por padrão e otimizações avançadas como Tail Call Optimization (TCO) e Pattern Matching.
    • Exemplos: Haskell, Elixir, Clojure, Scala, Erlang, F# e OCaml.
  • Linguagens Multiparadigma (com Forte Suporte Funcional): Permitem mesclar conceitos funcionais com orientação a objetos ou código imperativo, sendo as mais utilizadas no mercado do dia a dia.
    • Exemplos: JavaScript / TypeScript, Python, Kotlin, Rust e Swift.

2 – As características da programação funcional

A programação funcional possui 5 características principais e é fundamental entender cada uma delas para que possamos aplicar o paradgima corretamente em nosso dia a dia.

2.1 – Funções puras

São funções que produzem sempre o mesmo resultado para os mesmos argumentos e não geram efeitos colaterais no sistema (como alterar dados globais ou modificar o banco de dados).

JSPython

// Função pura: o resultado depende exclusivamente dos parâmetros
const calcularDesconto = (preco, percentual) => preco - (preco * (percentual / 100));

console.log(calcularDesconto(100, 15)); // Saída: 85

# Função pura equivalente
def calcular_desconto(preco: float, percentual: float) -> float:
    return preco - (preco * (percentual / 100))

print(calcular_desconto(100, 15))  # Saída: 85.0

2.2 – Funções de ordem superior

Funções que podem receber outras funções como argumentos ou retorná-las como resultado de sua execução. Permitem criar dinamicamente comportamentos reutilizáveis.

JSPython

// HOF que gera uma nova função personalizada
const criarFormatador = (prefixo) => (texto) => `${prefixo}: ${texto.trim()}`;

const formatarErro = criarFormatador('[ERRO]');
const formatarInfo = criarFormatador('[INFO]');

console.log(formatarErro(' Falha de Conexão ')); // Saída: [ERRO]: Falha de Conexão
console.log(formatarInfo(' Servidor Ativo '));   // Saída: [INFO]: Servidor Ativo

# HOF equivalente retornando uma expressão lambda
def criar_formatador(prefixo: str):
    return lambda texto: f"{prefixo}: {texto.strip()}"

formatar_erro = criar_formatador("[ERRO]")
formatar_info = criar_formatador("[INFO]")

print(formatar_erro(" Falha de Conexão "))  # Saída: [ERRO]: Falha de Conexão
print(formatar_info(" Servidor Ativo "))    # Saída: [INFO]: Servidor Ativo

2.3 Composição de funções

Consiste no encadeamento de duas ou mais funções simples para criar uma nova operação mais complexa, onde a saída de uma função serve diretamente como entrada para a próxima.

JSPython

const minusculas = (texto) => texto.toLowerCase();
const substituirEspacos = (texto) => texto.replace(/\s+/g, '-');

// Função de composição (pipeline)
const pipe = (...funcoes) => (valor) => funcoes.reduce((acc, fn) => fn(acc), valor);

const gerarSlug = pipe(minusculas, substituirEspacos);

console.log(gerarSlug('Programacao Funcional JS')); // Saída: programacao-funcional-js

from functools import reduce

def minusculas(texto: str) -> str:
    return texto.lower()

def substituir_espacos(texto: str) -> str:
    return "-".join(texto.split())

def pipe(*funcoes):
    return lambda valor: reduce(lambda acc, fn: fn(acc), funcoes, valor)

gerar_slug = pipe(minusculas, substituir_espacos)

print(gerar_slug("Programacao Funcional Python"))  # Saída: programacao-funcional-python

2.4 – Imutabilidade

Os dados depois de atribuídos para as variáveis, não sofrem mudanças, mantendo-se fixos até o fim da execução do código. Para modificar um objeto ou coleção, gera-se uma nova estrutura com o valor atualizado, preservando o estado original. Dessa forma, a imutabilidade torna o código mais previsível e estável, evitando efeitos colaterais inesperados durante o processamento. 

JSPython

const produtoOriginal = { nome: 'Teclado', preco: 150 };

// Atualização imutável usando spread operator (...)
const atualizarPreco = (produto, novoPreco) => ({ ...produto, preco: novoPreco });

const produtoAtualizado = atualizarPreco(produtoOriginal, 180);

console.log(produtoOriginal);  // Saída: { nome: 'Teclado', preco: 150 } (Preservado)
console.log(produtoAtualizado); // Saída: { nome: 'Teclado', preco: 180 }

produto_original = {"nome": "Teclado", "preco": 150}

# Atualização imutável usando desempacotamento de dicionário
def atualizar_preco(produto: dict, novo_preco: float) -> dict:
    return {**produto, "preco": novo_preco}

produto_atualizado = atualizar_preco(produto_original, 180)

print(produto_original)   # Saída: {'nome': 'Teclado', 'preco': 150} (Preservado)
print(produto_atualizado) # Saída: {'nome': 'Teclado', 'preco': 180}

2.5 – Recursividade

Na programação funcional, loops de repetição imperativos (for, while) não são utilizados. No lugar dos loops é adotada a recursividade. Ela é uma estratégia na qual a função invoca a si mesma sucessivamente dividindo o problema até atingir uma condição de parada pré-definida (chamada de caso base).

JSPython

// Soma dos elementos de uma lista usando desestruturação e recursão
const somarLista = ([cabeca, ...cauda]) => {
  if (cabeca === undefined) return 0; // Caso base
  return cabeca + somarLista(cauda);   // Passo recursivo
};

console.log(somarLista([10, 20, 30, 40])); // Saída: 100

# Soma dos elementos de uma lista usando fatiamento e recursão
def somar_lista(lista: list) -> int:
    if not lista:  # Caso base
        return 0
    return lista[0] + somar_lista(lista[1:])  # Passo recursivo

print(somar_lista([10, 20, 30, 40]))  # Saída: 100

3 – Usando paradigma funcional no dia a dia 

O ecossistema moderno de desenvolvimento de software mudou drasticamente nos últimos anos com o advento dos modelos de linguagem (LLMs) e a consolidação de assistentes de IA. Atualmente, escrever código imperativo repleto de loops manuais e mutações de estado tornou-se algo redundante. Geradores de código baseados em IA replicam com extrema facilidade padrões funcionais limpos, declarativos e seguros.

Dessa forma, dominar a programação funcional elevou-se de um diferencial estético para uma habilidade essencial de engenharia de software:

  • Previsibilidade para Revisão de Código: Quando construímos sistemas com funções puras e imutabilidade, o escopo de qualquer alteração fica restrito àquela função específica. Isso reduz drasticamente o esforço cognitivo exigido de um desenvolvedor para revisar blocos de código gerados ou refatorados por inteligência artificial.
  • Segurança em Ambientes Concorrentes e Reativos: Com o crescimento de arquiteturas voltadas a microsserviços, processamento de eventos em tempo real e pipelines robustos de Inteligência Data-Driven, a ausência de efeitos colaterais evita bugs difíceis de rastrear, como condições de corrida (race conditions).
  • Eficiência em Data Science e Pipelines: Linguagens e bibliotecas modernas utilizam amplamente abordagens funcionais (map, filter, reduce) para manipular grandes volumes de dados de forma concisa, otimizando o treinamento e a estruturação de fluxos de dados consumidos por modelos preditivos.
———

Seja utilizando linguagens puramente funcionais — como Haskell, Elixir e OCaml — ou aplicando conceitos funcionais em ecossistemas multiparadigma populares do dia a dia (como JavaScript/TypeScript, Python e Kotlin), o paradigma funcional entrega a base lógica ideal para produzir softwares escaláveis, testáveis e perfeitamente alinhados à era da automação inteligente.

A programação Funcional transcende a sintaxe ou o uso de uma ferramenta específica, pois, trata-se de uma profunda mudança de mentalidade na forma como concebemos a lógica de computadores. Ao priorizar expressões determinísticas, isolar efeitos colaterais e tratar dados como imutáveis, construímos aplicações capazes de evoluir com estabilidade em ambientes altamente dinâmicos.

Em um mercado impulsionado por sistemas distribuídos e aceleração via Inteligência Artificial, os conceitos funcionais deixam de ser opcionais para se tornarem o padrão ouro na entrega de um código limpo, resiliente e pronto para o futuro.

Espero que este texto seja útil de alguma forma para você e contribua com sua jornada acadêmica e profissional!

Gostou do conteúdo? Compartilhe com seus amigos e aproveite para conhecer mais sobre paradigmas de programação aqui!